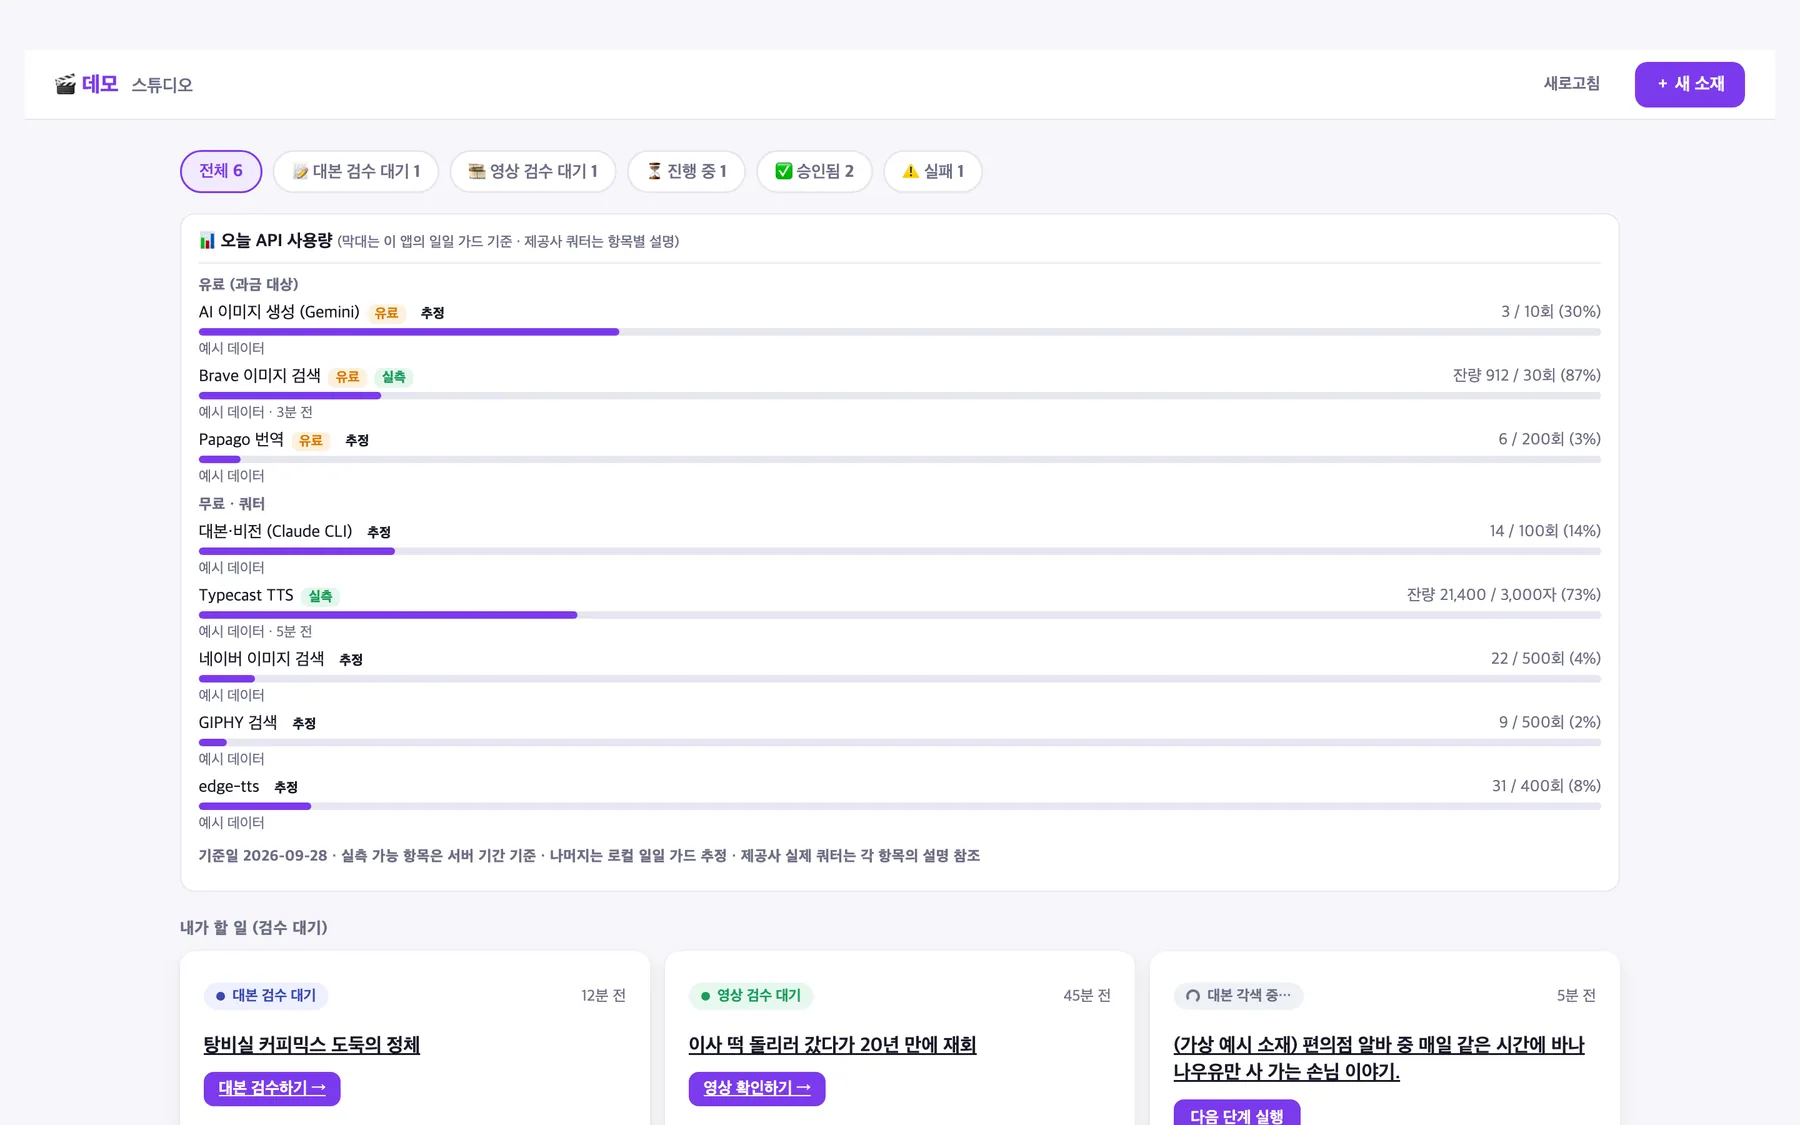
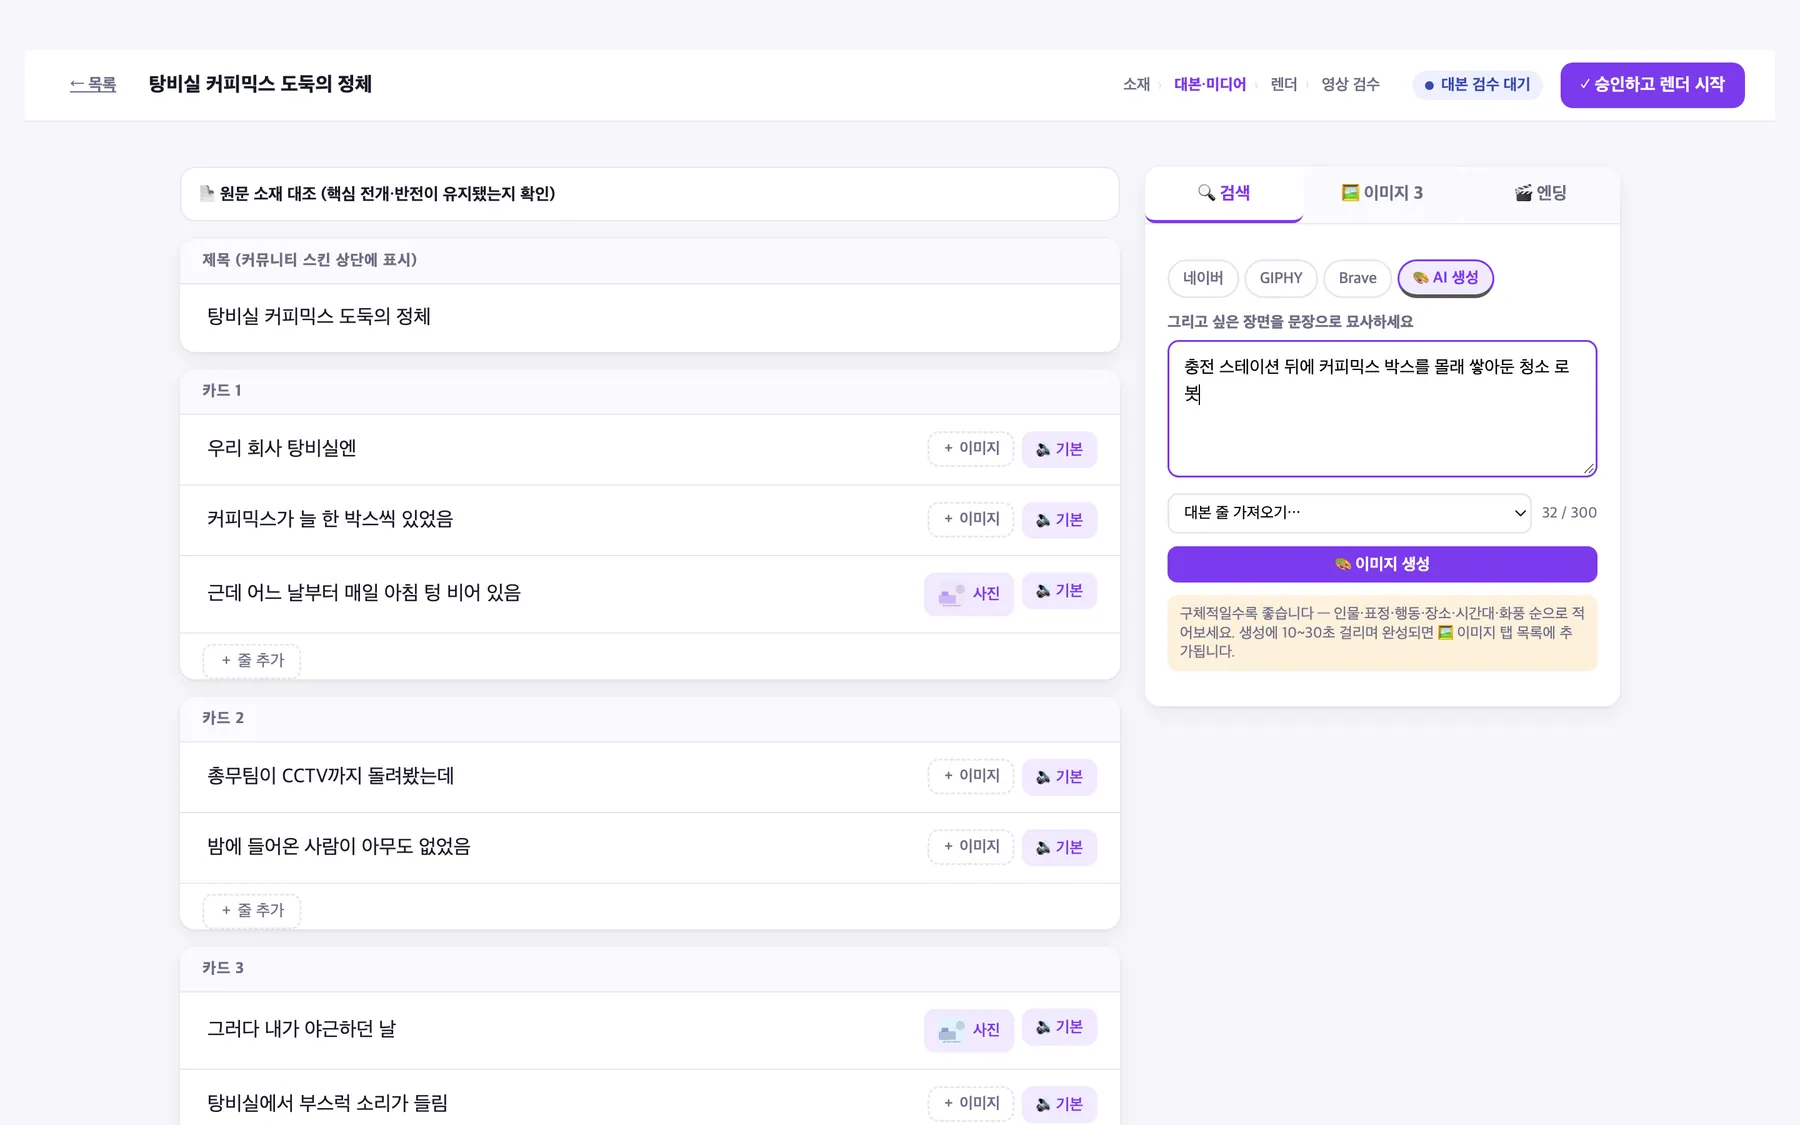
썰 쇼츠 한 편을 손으로 만들면 대본 각색, 나레이션, 줄마다 자막 타이밍, 이미지 배치, 편집을 모두 해야 합니다. 전부 자동화하면 원문 표현 재사용, 원본 게시물 사진 무단 사용, 이야기 과변형 같은 품질·저작권 사고를 걸러낼 사람이 없고, 유료 API를 섞어 쓰면 비용이 조용히 샙니다. 그래서 반복 작업은 파이프라인에 맡기고, 판단이 필요한 대본·미디어와 최종 영상 두 지점에만 사람이 개입하도록 설계했습니다.
Overview
Features
- 소재 → 대본 자동 각색: 텍스트나 캡처 이미지를 넣으면 LLM이 카드·줄 단위 대본으로 각색, 원문 표현 재사용 금지·이야기 뼈대 보존 규칙과 스키마 검증
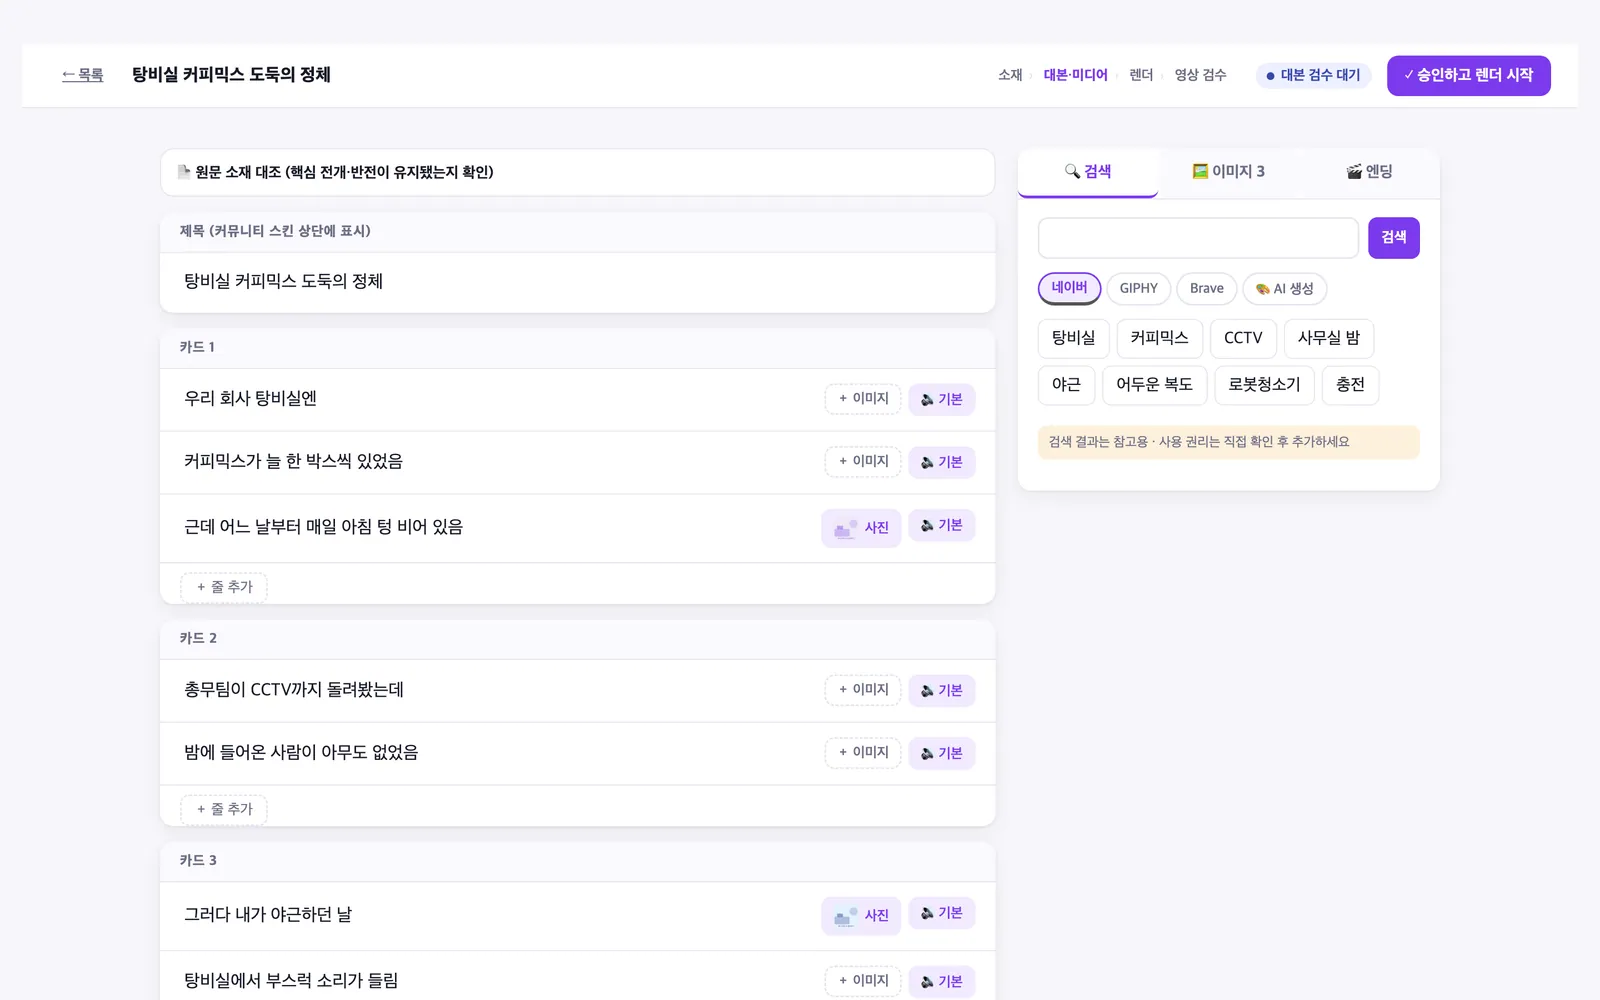
- 검수 대시보드(게이트 ①): 줄 인라인 편집, 줄별 이미지·움짤·효과음·목소리 배정, 참고용 이미지 검색과 텍스트 프롬프트 기반 AI 이미지 생성
- 정확한 타이밍의 오디오·자막: 줄 단위 TTS를 PCM 샘플 수 기준으로 이어 붙이고 영상 구간을 프레임 그리드에 누적 스냅, 바뀐 줄만 다시 합성하는 TTS 캐시
- 커뮤니티 카드 렌더: 게시판 스킨 카드에 줄이 쌓이는 형식을 Pillow로 합성하고 GIF·효과음·BGM·엔딩 카드를 FFmpeg 한 번으로 합침
- 검수 게이트 ②와 수정 흐름: 승인·반려·대본 편집으로 되돌리기, 승인한 Job 복제, 제공사별 API 사용량 패널
Architecture
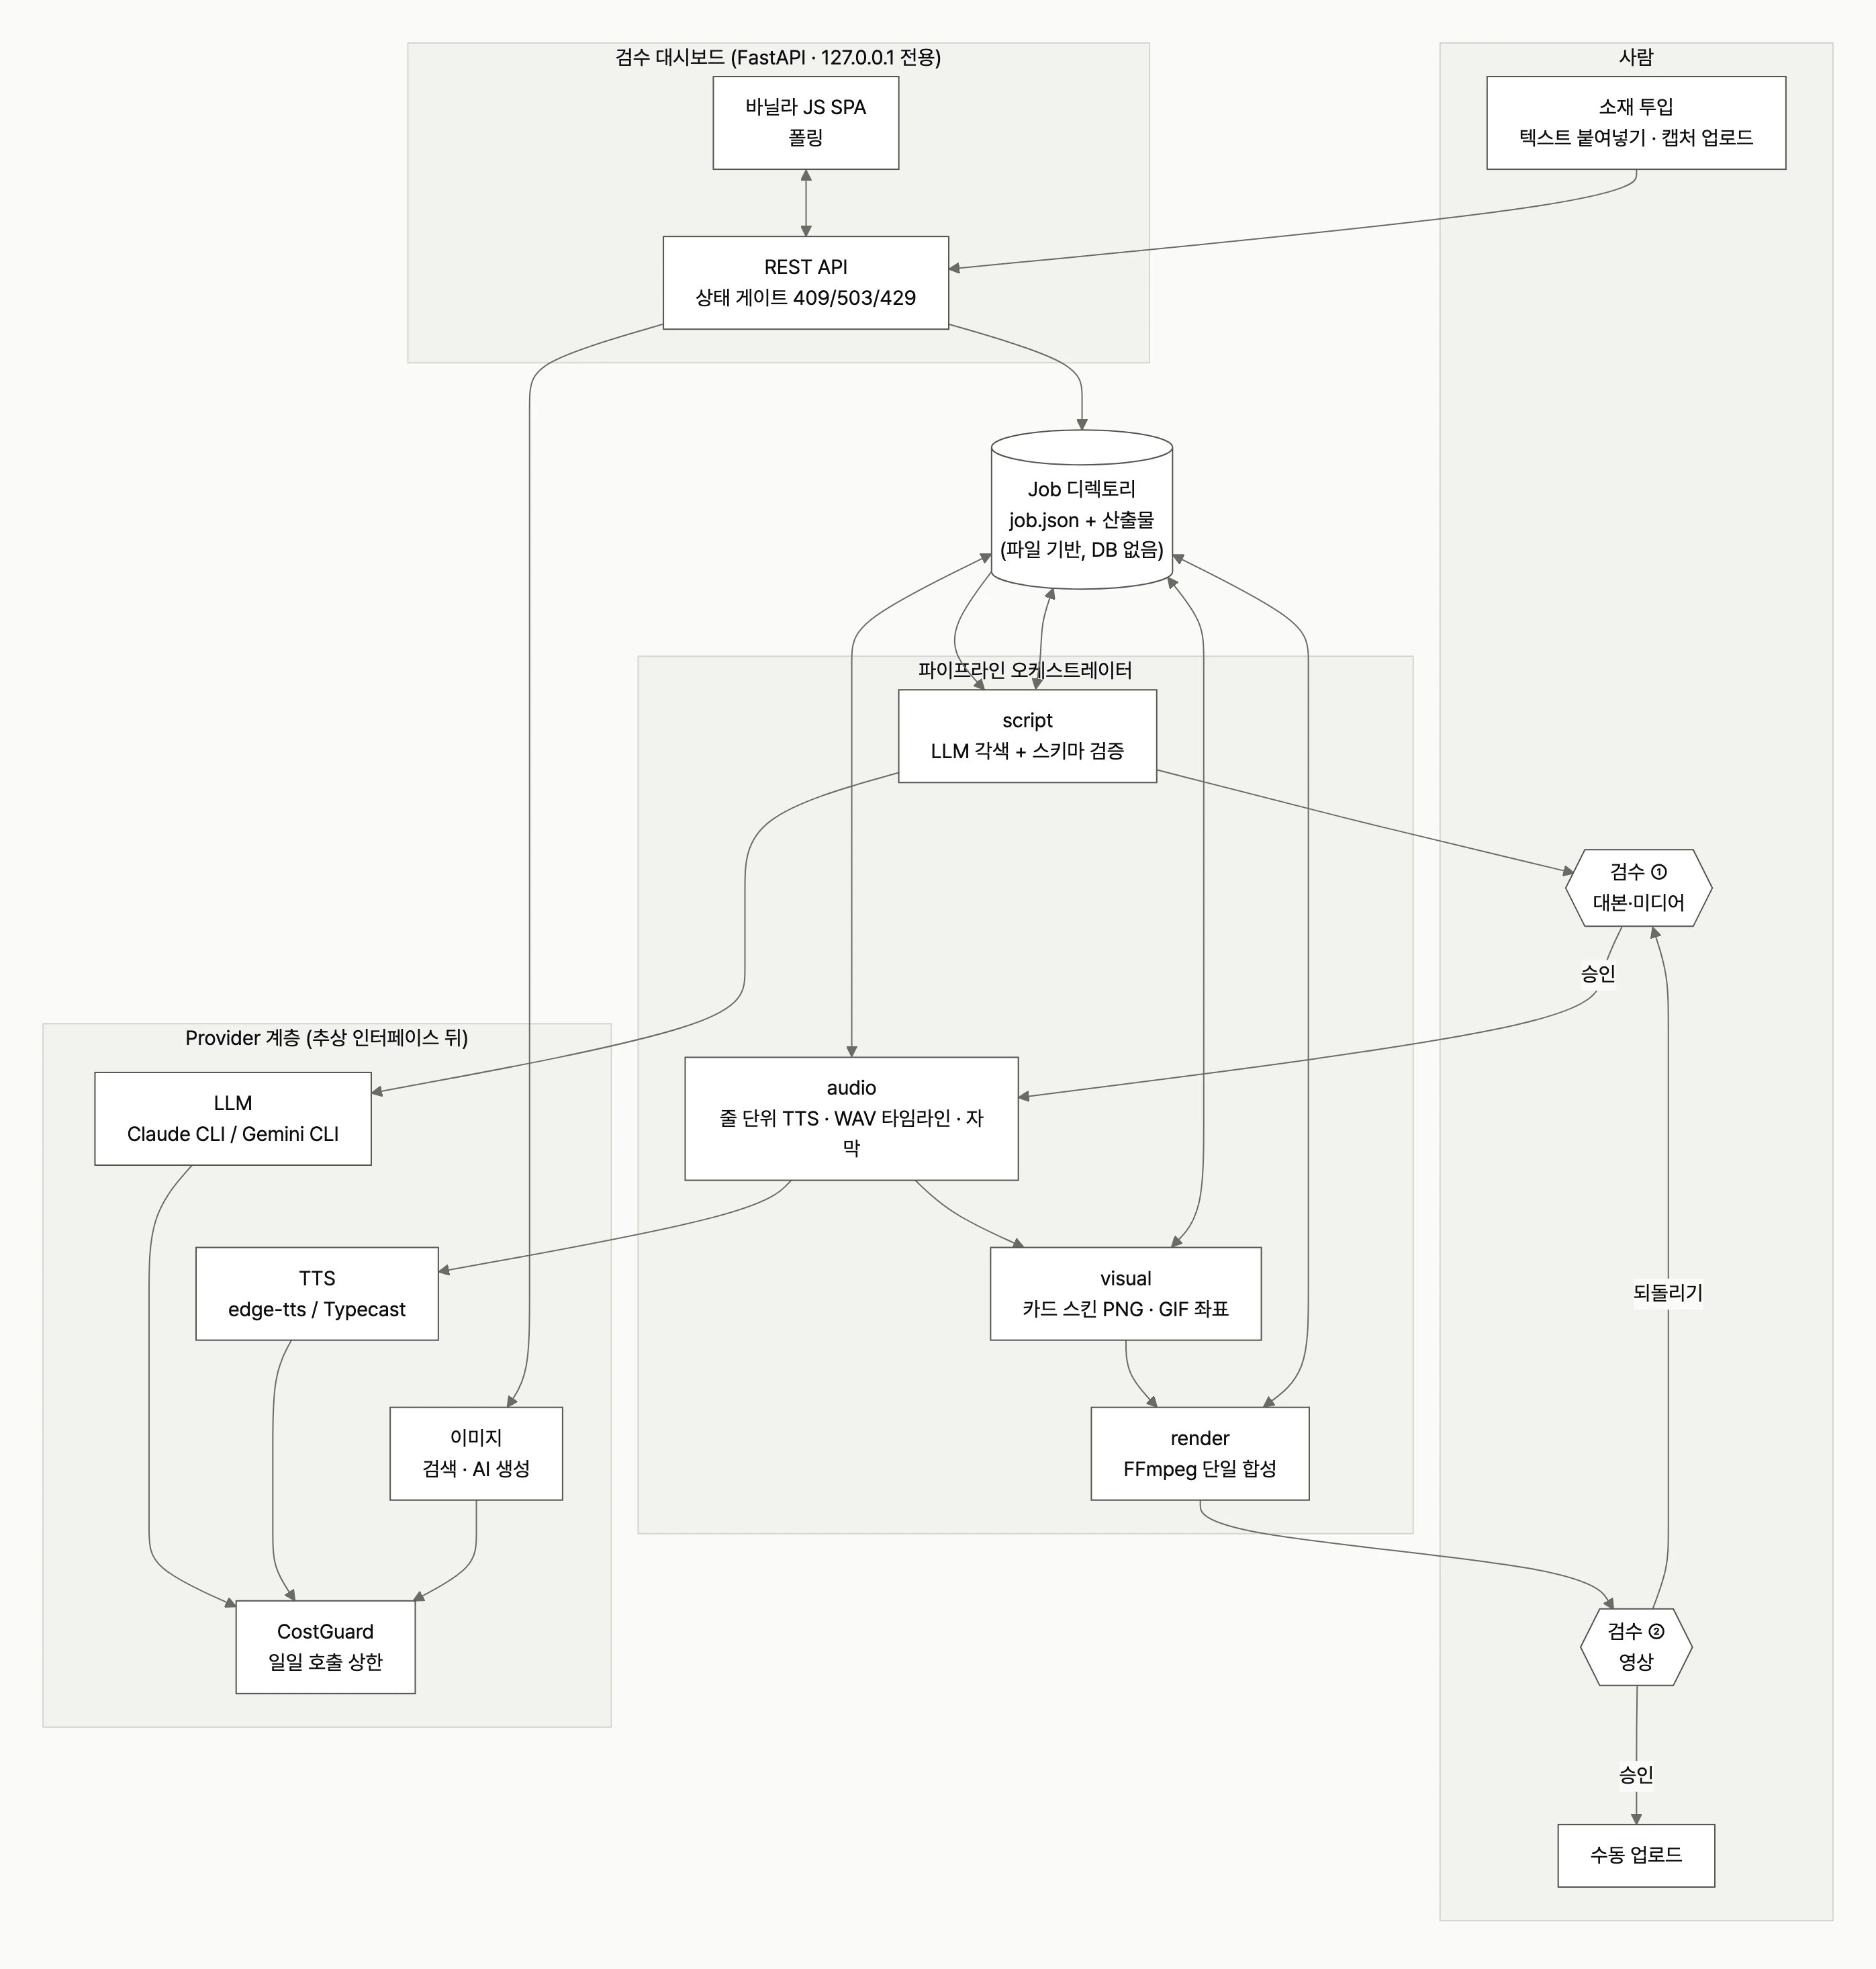
다이어그램 원문 (Mermaid)
flowchart TB
    subgraph Human["사람"]
        IN["소재 투입<br/>텍스트 붙여넣기 · 캡처 업로드"]
        G1{{"검수 ①<br/>대본·미디어"}}
        G2{{"검수 ②<br/>영상"}}
        UP["수동 업로드"]
    end
    subgraph Dash["검수 대시보드 (FastAPI · 127.0.0.1 전용)"]
        API["REST API<br/>상태 게이트 409/503/429"]
        UI["바닐라 JS SPA<br/>폴링"]
    end
    subgraph Pipe["파이프라인 오케스트레이터"]
        S1["script<br/>LLM 각색 + 스키마 검증"]
        S2["audio<br/>줄 단위 TTS · WAV 타임라인 · 자막"]
        S3["visual<br/>카드 스킨 PNG · GIF 좌표"]
        S4["render<br/>FFmpeg 단일 합성"]
    end
    subgraph Ports["Provider 계층 (추상 인터페이스 뒤)"]
        LLM["LLM<br/>Claude CLI / Gemini CLI"]
        TTS["TTS<br/>edge-tts / Typecast"]
        IMG["이미지<br/>검색 · AI 생성"]
        CG["CostGuard<br/>일일 호출 상한"]
        LLM ~~~ TTS ~~~ IMG
    end
    STORE[("Job 디렉토리<br/>job.json + 산출물<br/>(파일 기반, DB 없음)")]
    IN --> API --> STORE
    STORE --> S1 --> G1
    G1 -->|승인| S2 --> S3 --> S4 --> G2
    G2 -->|되돌리기| G1
    G2 -->|승인| UP
    UI <--> API
    S1 & S2 & S3 & S4 <--> STORE
    S1 --> LLM
    S2 --> TTS
    API --> IMG
    LLM & TTS & IMG --> CG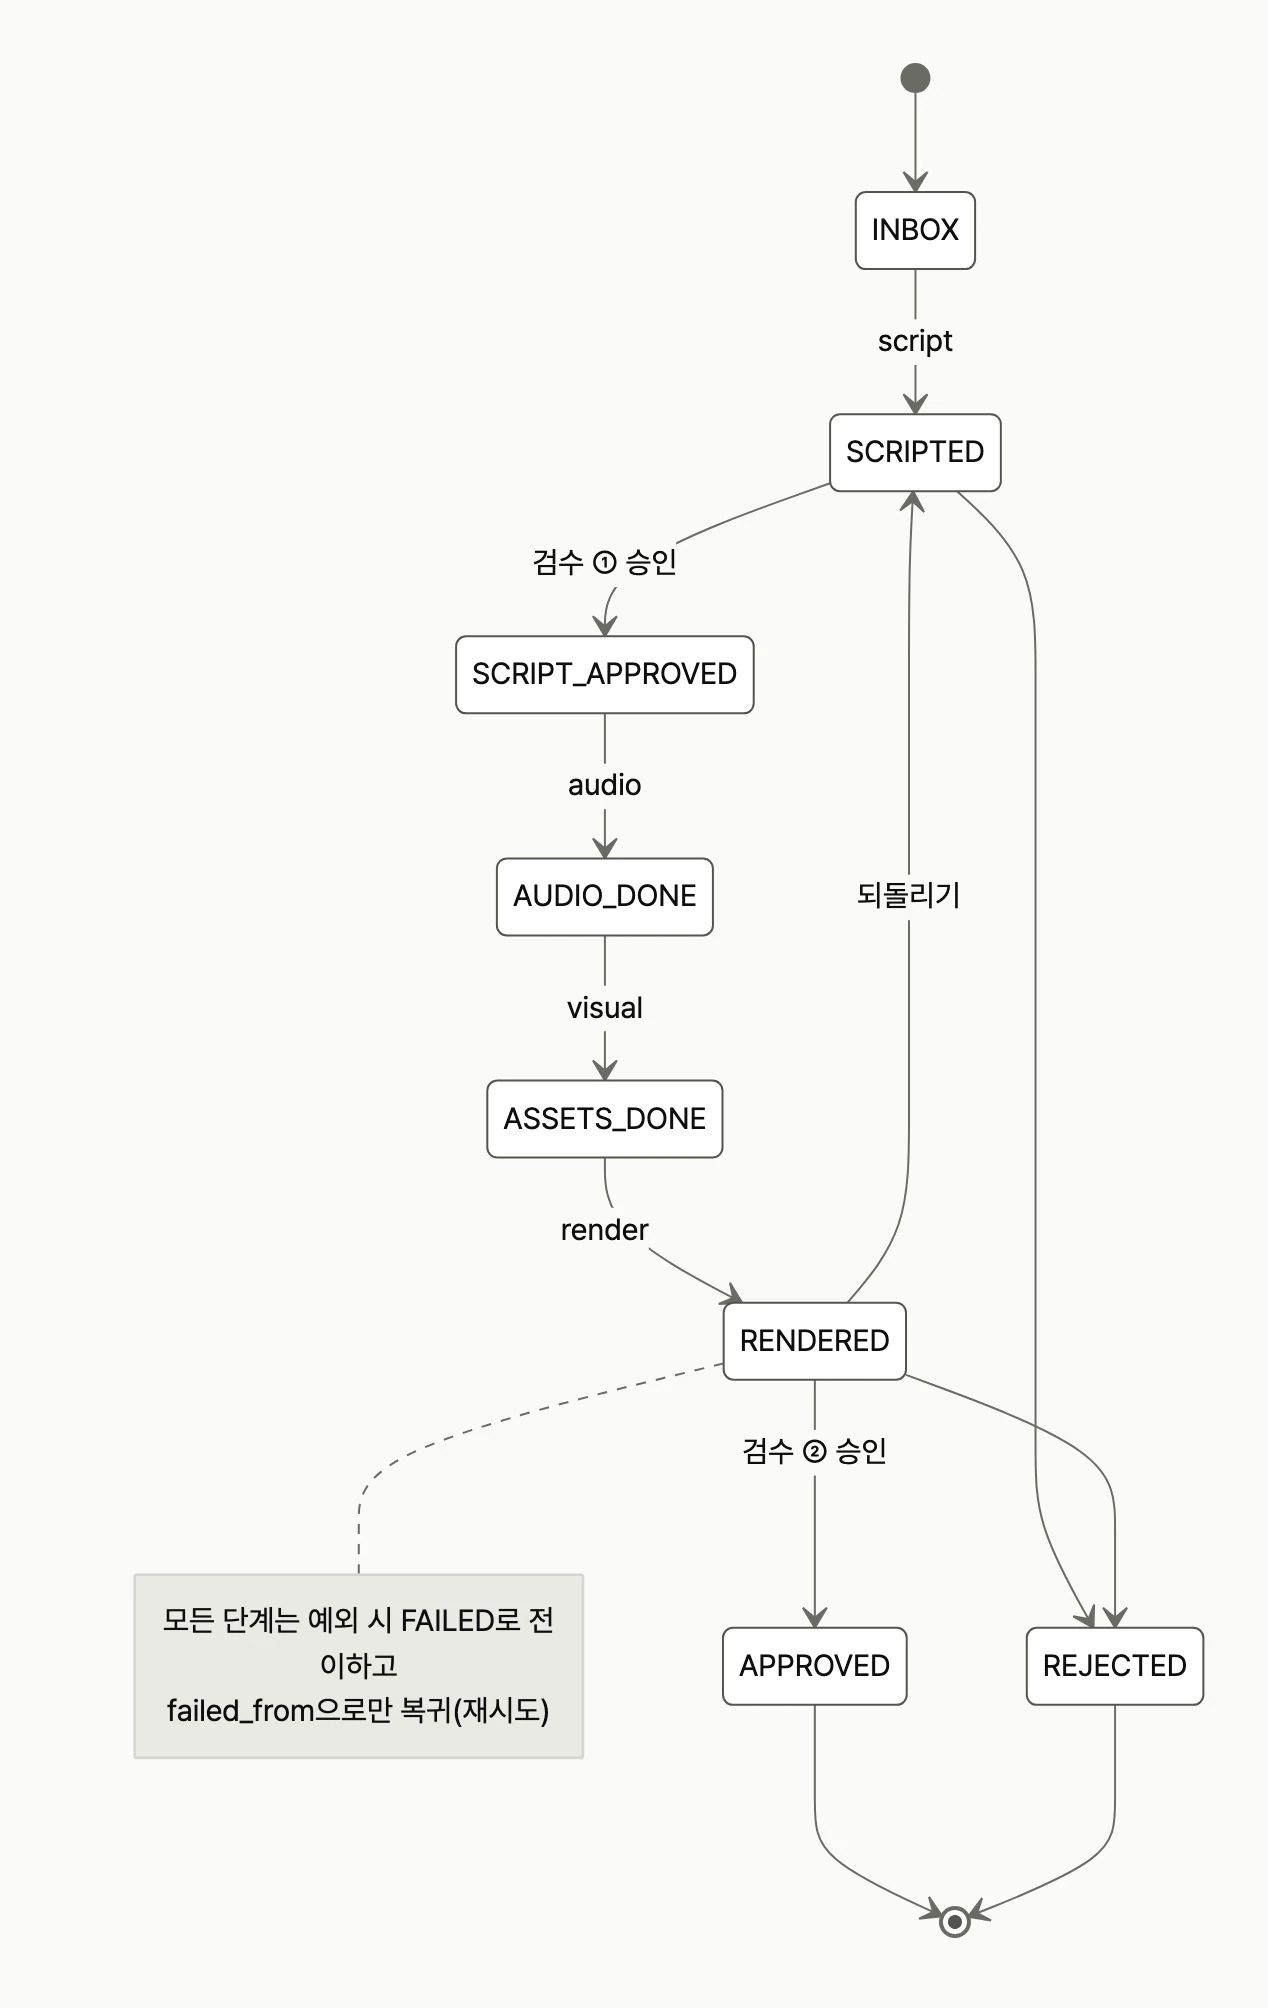
다이어그램 원문 (Mermaid)
stateDiagram-v2
    [*] --> INBOX
    INBOX --> SCRIPTED: script
    SCRIPTED --> SCRIPT_APPROVED: 검수 ① 승인
    SCRIPTED --> REJECTED
    SCRIPT_APPROVED --> AUDIO_DONE: audio
    AUDIO_DONE --> ASSETS_DONE: visual
    ASSETS_DONE --> RENDERED: render
    RENDERED --> APPROVED: 검수 ② 승인
    RENDERED --> SCRIPTED: 되돌리기
    RENDERED --> REJECTED
    APPROVED --> [*]
    REJECTED --> [*]
    note right of RENDERED
      모든 단계는 예외 시 FAILED로 전이하고
      failed_from으로만 복귀(재시도)
end noteKey decisions
타임라인은 mp3 길이가 아니라 PCM 샘플 수로
mp3 길이로 줄 시작 시각을 계산하면 인코더 패딩 때문에 줄마다 오차가 쌓여 자막이 밀렸습니다. 모든 줄을 WAV로 디코딩해 앞뒤 무음을 잘라낸 뒤 샘플 수로 타임라인을 계산하고, 영상 구간을 프레임 그리드에 누적 스냅해 오차가 한 프레임을 넘지 않게 했습니다. 이후 겪은 렌더 결함도 원인과 함께 렌더 불변식 표로 정리하고 회귀 테스트를 붙였습니다.
Ports & Adapters + 파일 기반 Job 저장소
LLM·TTS·검색·이미지 생성·렌더는 추상 인터페이스 뒤에 두고 조합은 설정과 레지스트리가 정합니다. 저장소는 DB 없이 Job 하나가 디렉토리 하나이고, 모든 쓰기를 임시 파일에 쓴 뒤 원자적으로 교체합니다. 스키마를 강화할 때마다 하위호환 validator와 구 스키마 fixture 테스트를 함께 넣습니다.
완전 자동이 아니라 검수 게이트 두 개
LLM 각색은 인물 관계를 바꾸거나 원문 표현을 옮길 위험이 있어, 대본·미디어와 최종 영상 두 곳에 사람의 판단을 고정했습니다. 영상 검수에서 되돌리면 같은 Job이 대본 단계로 돌아가고, 다시 렌더할 때 바뀐 줄의 유료 TTS만 다시 호출합니다.
Security
- 로컬 전용 대시보드: 127.0.0.1 바인딩 고정, OpenAPI 문서 비활성화
- 시크릿은 .env에만 두고 gitignore 포함 여부를 검증, 모든 로거에 마스킹 필터
- 안전한 서브프로세스: shell=True 금지, 리스트 인자와 timeout 필수, 외부 경로는 프로젝트 하위인지 검증
- 비용 방어선: 유료·쿼터 API는 호출 직전 CostGuard를 거치고 일일 상한을 넘으면 즉시 중단
- SSRF 게이트: 검색 결과 다운로드는 방금 그 검색이 반환한 URL 집합에 있는 것만 허용
- 저작권·출처 추적: 원본 게시물 사진은 원작자 허락 근거가 기록된 경우만 입력 허용, 모든 이미지에 출처 기록, 자동 크롤링 코드 없음
Status
운영 중
개인 로컬 도구로 실제 여러 편을 생산·승인했고, 실사용 중 발견한 품질·편집·렌더 문제를 단계별로 고쳐 왔습니다. 소재 수집 보조는 설계만 끝난 상태입니다.
Screens
Screens